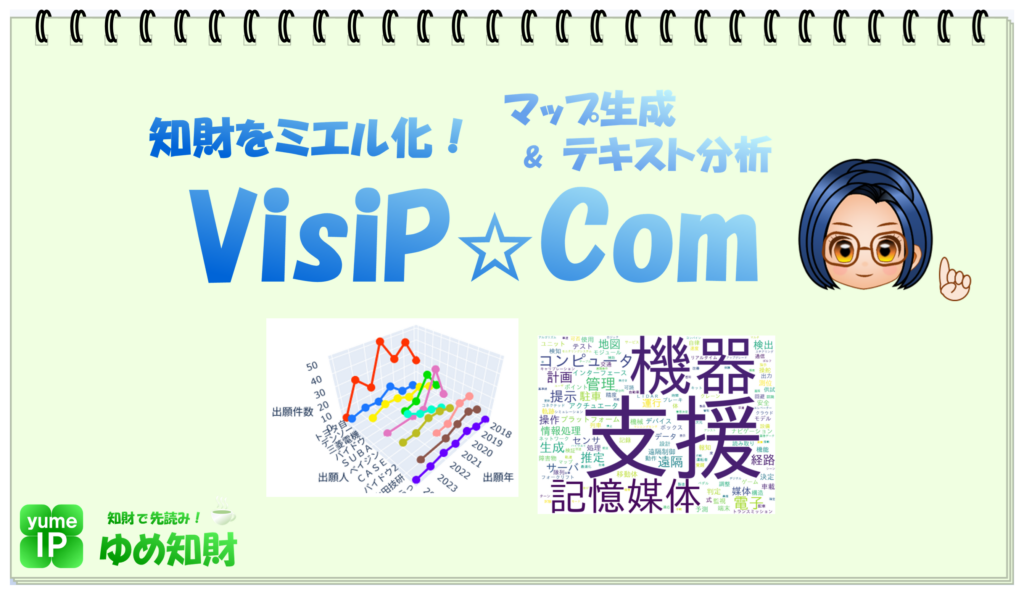
特許マップによる可視化とテキストマイニングを一つのWebアプリで行う「VisiP☆Com」について、基本的な使い方や分析結果の見方、利用時の注意点などを説明します。
現在のVisiP☆Comはこちらです。
VisiP☆Comとは
VisiP☆Comは、特許データのテキストマイニングと特許マップによる可視化を、一つの処理の中で行うためのWebアプリです。
VisiP☆Texでは、特許データの「発明の名称」や「要約」からキーワードを抽出して分析します。VisiP☆Mapでは、出願人、出願年、特許分類、キーワードなどの項目を組み合わせて特許マップを作成します。VisiP☆Comでは、これらを一連の流れで行うことができます。
そのため、テキストマイニングしたデータをいったんダウンロードし、あらためて特許マップ作成用のデータとして登録するといった作業をせずに、キーワードを利用した特許マップまで確認できます。
基本的な使い方
VisiP☆Comでは、基本的に次の流れで分析します。
- 特許データを登録する
- 2つの軸データ項目を選ぶ
- 初期表示件数を選ぶ
- 必要に応じて辞書を登録する
- データ解析を実行する
- 特許マップやテキストマイニングの結果を確認する
- 必要に応じて処理後のデータをダウンロードする
手元に特許データがない場合は、サンプルデータを使って操作を試すこともできます。
特許データを登録する
分析する特許データのファイルを登録します。
受付可能なファイル形式は、VisiPが対応するCSVまたはExcel形式の特許データです。
VisiPが現在対応している特許情報サービスについては、このマニュアルでは個別に列挙していません。最新の対応状況はVisiPポータルでご確認ください。
各特許情報サービスからダウンロードしたデータを利用する場合は、できるだけ元のデータ構造を維持したまま使用することをお勧めします。
アップロード1回あたりの上限は約10MBです。
辞書ファイルも同時に登録する場合は、それらを含めたアップロード全体が上限の対象となります。上限に近い場合は、アップロード時の付加情報によって先に上限へ達することがあります。
2つの軸データ項目を選ぶ
「軸データ項目1」と「軸データ項目2」で、特許マップに使用する2つの項目を選択します。
初期状態では、
- 軸データ項目1:出願人
- 軸データ項目2:出願年
が選択されています。
選択できる項目は次の9種類です。
- 出願人
- 発明者
- 出願年
- 公開年
- 優先年
- 特許分類
- 特許分類(翻訳あり)
- 発明の名称(キーワード)
- 要約(キーワード)
VisiP☆Mapとの大きな違いの一つは、VisiP☆Comではテキストマイニングも同時に行うため、「発明の名称(キーワード)」「要約(キーワード)」を利用するために、あらかじめVisiP☆Texで処理したデータを用意する必要がないことです。
例えば、出願人 × 出願年、出願人 × 特許分類、出願人 × 発明の名称(キーワード)、出願年 × 要約(キーワード)など、目的に応じて組み合わせを変えることができます。
選択した項目に必要なデータが元ファイルに含まれていない場合は、適切な分析結果を得られないことがあります。
初期表示件数を選ぶ
「初期表示件数」で、特許マップを最初に何件表示するかを設定します。
選択肢は、
- 5
- 10
- 15
- 20
です。初期値は「10」です。解析後の結果画面では、グラフに応じて表示件数や大きさなどをさらに調整できます。
必要に応じて4種類の辞書を登録する
VisiP☆Comでは、分析結果を調整するため、必要に応じて次の4種類の辞書を利用できます。
- 抽出語
- 除外語
- 同義語
- 出願人統合
辞書はいずれも任意です。
抽出語・除外語・同義語
「抽出語」は、テキストマイニングで抽出したい語を指定するために使用します。「除外語」は、分析結果から除きたい語を指定するために使用します。「同義語」は、異なる表現を分析上同じ言葉としてまとめるために使用します。
抽出語と除外語はテキストファイル(.txt)、同義語はCSV(.csv)またはExcel(.xls、.xlsx)を使用します。辞書の考え方については、VisiP☆Tex利用マニュアルも参考にしてください。
出願人統合
「出願人統合」は、出願人名の表記ゆれなどをまとめて扱うための辞書です。
CSV(.csv)またはExcel(.xls、.xlsx)ファイルを1ファイル登録できます。辞書は、ヘッダーなしの2列で作成します。
- 第1列:統合前の出願人名
- 第2列:統合後の出願人名
1行につき1組を記載します。複数の異なる出願人名を、同じ統合後名称へまとめることもできます。
出願人名の照合は完全一致です。文字列の一部が一致するだけでは統合されません。
また、ユーザーが登録した出願人統合辞書による処理後にも、VisiP内部の出願人整形処理が行われます。
統合後の出願人名は、
- 特許マップ
- 出願人別カテゴリ
- ダウンロードする
processed.csv
へ反映されます。一方、wordlist.csvには反映されません。
データ解析を実行する
特許データ、軸データ項目、初期表示件数を設定し、必要に応じて辞書を登録したら、データ解析を実行します。VisiP☆Comでは、特許データのテキストマイニングと、特許マップ作成に必要な処理をまとめて行います。
Tex/Comでは、処理対象データの「発明の名称」と「要約」の文字数を合計し、400,000文字まで処理できます。400,001文字以上の場合は処理できず、「テキスト総文字数は400000文字までです。」と表示されます。データ量が多い場合は、分析対象を減らすなどして文字数を調整してください。
サンプルデータを使う
手元に分析用の特許データがなくても、用意されているサンプルデータを利用できます。初めてVisiP☆Comを使う場合は、まずサンプルデータで特許マップやテキストマイニングの結果を確認すると、全体の流れを理解しやすくなります。
6種類の特許マップを見る
VisiP☆Comでは、VisiP☆Mapと同じ6種類のグラフを表示できます。
- 件数ランキング
- 件数シェア
- 件数トレンド
- 積上げトレンド
- 3Dプロファイル
- バブルプロファイル
「件数ランキング」や「件数シェア」では、どの出願人、分類、キーワードなどが多いかを確認できます。「件数トレンド」「積上げトレンド」では、年などの時系列項目と組み合わせて変化を見ることができます。「3Dプロファイル」「バブルプロファイル」では、2つの軸データ項目の関係を視覚的に確認できます。
各グラフの特徴については、VisiP☆Map利用マニュアルでも詳しく説明しています。
スライドバーで特許マップをインタラクティブに調整する
VisiP☆Comでは、解析後の特許マップについて、VisiP独自のスライドバーを動かしながら表示を変更できます。
グラフに応じて、
- データ数
- 横軸データ数
- 縦軸データ数
- 幅 (px)
- 高さ (px)
- バブルサイズ
を調整できます。例えば、横軸や縦軸に表示するデータ数を増減させたり、グラフ自体の大きさを変えたり、バブルプロファイルのバブルサイズを調整したりできます。スライドバーを動かすと、その設定に応じてグラフの表示が変化します。結果を見ながら表示条件を変えることで、初期表示だけでは気付きにくい特徴を確認できる場合があります。
Plotlyの機能でグラフそのものを操作する
VisiP☆Comでは、特許マップの表示にPlotly(プロットリー)というグラフ作成用のソフトウェアライブラリを利用しています。そのため、VisiP独自のスライドバーとは別に、Plotlyが備えているインタラクティブ機能も利用できます。
グラフの種類に応じて、拡大・縮小、表示範囲の変更、3Dグラフの視点変更などの操作ができます。
グラフ右上にはPlotlyの標準ツールバーも表示され、グラフの表示操作や画像としての保存など、Plotlyが提供する機能を利用できます。これはVisiP独自の結果ダウンロード機能とは異なります。
テキストマイニングの結果を見る
VisiP☆Comでは、特許マップとあわせて、特許データの「発明の名称」や「要約」から抽出したキーワードを確認できます。
テキストマイニングは、文章を単語などに分け、その中から特徴や傾向を見つける分析方法です。VisiP☆Comでは、テキストマイニングによって得られたキーワードを確認するとともに、そのキーワードを特許マップの軸として利用できます。
これにより、例えば特定の出願人がどのようなキーワードを多く使っているか、特定の時期にどのようなキーワードが現れているかなどを、特許マップとして見ることができます。
ワードクラウドで特徴的な言葉を見る
テキストマイニングの結果は、ワードクラウドでも確認できます。
ワードクラウドとは、文章から切り出された単語を、出現頻度などに応じて文字の大きさを変えて配置し、視覚的に表現する方法です。多く使われている言葉や特徴的な言葉を、直感的に確認できます。
ただし、文字が大きいというだけで、その言葉が技術的・事業的に重要とは限りません。元の特許データや個々の公報も確認しながら、分析の入口として利用してください。
共起ネットワークで言葉どうしの関係を見る
VisiP☆Comでは、テキストマイニングした言葉どうしの関係を共起ネットワークでも確認できます。
共起とは、複数の言葉が同じ文章の中などで一緒に現れることをいいます。共起ネットワークでは、一緒に現れやすい言葉どうしの関係をネットワークとして可視化します。
ワードクラウドが「どの言葉が多く使われているか」を見るのに向いているのに対し、共起ネットワークでは、「どの言葉とどの言葉が関連して現れているか」を見ることができます。
ただし、共起しているからといって、必ずしも技術的・因果的な関係があるとは限りません。元データや個々の公報と照らし合わせながら、分析の入口として利用してください。
処理したデータをダウンロードする
VisiP☆Comでは、処理結果を2種類のCSVファイルとしてダウンロードできます。
特許データをダウンロード
「特許データをダウンロード」から、processed.csvをダウンロードできます。文字コードはUTF-8-SIGです。
このファイルには、元の特許データに加えて、テキストマイニングによって得られたキーワード情報など、VisiP☆Comで処理した情報が含まれます。出願人統合辞書を使用した場合は、統合後の出願人名も反映されます。処理後のデータを別の分析に利用したい場合や、手元に保存しておきたい場合に利用できます。
ワードリストをダウンロード
「ワードリストをダウンロード」から、wordlist.csvをダウンロードできます。文字コードはUTF-8-SIGです。抽出された語をCSVとして確認・整理したい場合などに利用できます。出願人統合辞書による出願人名の変更は、このワードリストには反映されません。
エラーが表示された場合
ファイルやデータの状態、文字数、解析後の経過時間などによって、処理や操作ができない場合があります。
まず、対応するファイル形式か、ファイルサイズが大きすぎないか、選択した軸に必要なデータが含まれているか、「発明の名称」と「要約」の合計文字数が400,000文字を超えていないか、辞書を利用する場合は辞書が適切に用意されているかなどを確認してください。
出願人統合辞書を利用する場合は、ヘッダーなし2列で作成されているか、統合前名称が元データの出願人名と完全一致しているかも確認してください。
アップロード上限を超えた場合は、「アップロードファイルが上限を超えています。」と表示されます。その場合は、ファイルサイズを小さくしてから再度登録してください。
文字数が上限を超えた場合は、「テキスト総文字数は400000文字までです。」と表示されます。この場合は、分析する特許データを減らすなどしてから再度処理してください。
解析後、時間が経過してから操作できなくなった場合
VisiPでは、アップロードしたデータや解析時に作成した一時データをサーバー上へ長期間保存する仕組みにはしていません。解析後、一定時間が経過すると一時データが自動的に削除されます。
そのため、解析結果を表示したまましばらく時間を置いた後で、スライドバーによる特許マップの調整などを行おうとすると、元となるデータがすでに削除されており、エラーになる場合があります。この場合は、特許データと必要な辞書をもう一度登録して、再度データ解析を行ってください。
利用にあたって
VisiP☆Comは、特許マップとテキストマイニングを組み合わせ、特許情報を複数の角度から見るための支援ツールです。
例えば、出願人や年、特許分類などの書誌情報だけでなく、発明の名称や要約から抽出したキーワードも組み合わせることで、同じ特許データを異なる視点から確認できます。
一方、グラフ、ワードクラウド、共起ネットワークなどに表示された結果だけで、技術内容や事業上の意味を判断できるわけではありません。必要に応じて、元の特許公報や検索結果も確認しながら利用してください。
また、元の特許データや作成した辞書は、お手元にも保存しておくことをお勧めします。
VisiP☆Comに関するご意見、ご要望、不具合等がありましたら、お問い合わせページからお知らせください。